MAI-Code-1.1-Flash 로컬 버전, 16GB Mac mini에서 시도하기 전에 계산한 메모리
Microsoft가 공개한 MAI-Code-1.1-Flash 로컬 버전의 크기 53GB, 256K 컨텍스트 피크 메모리 75.5GB, 권장 120GB 초과 수치로 M4 Mac mini 16GB에서 시도할 수 있는지 계산했습니다. 직접 실행한 기록이 아니라 공개 수치 기반 사전 점검입니다.
결론 먼저
로컬 버전의 가중치만 53GB라서 M4 Mac mini 16GB에서는 시도할 이유가 없습니다. Microsoft가 잰 피크 메모리는 256K 컨텍스트에서 75.5GB이고 권장 사양은 RAM 120GB 초과입니다.
- 실험 환경
- 기준 기기는 Apple M4 Mac mini 16GB입니다. 모델을 받아 실행하지는 않았고, Microsoft가 공개한 수치로 계산한 사전 점검입니다.
- 누구에게 유용한가
- Microsoft의 로컬 코딩 모델 소식을 보고 내 Mac이나 PC에서 되는지 먼저 따져보려는 사람
확인한 자료와 한계
- Microsoft Windows Command Line 블로그, Bringing local models and sandboxed tools to Windows and GitHub Copilot (2026-10-07)
- Microsoft AI, MAI-Code-1.1-Flash: Better, faster, at a quarter of the cost (2026-10-07 갱신)
- GitHub changelog, MAI-Code-1.1-Flash available in GitHub Copilot (2026-08-11)
실행 결과, 토큰 생성 속도, Apple Silicon 지원 여부는 확인하지 못했습니다. 세 자료는 2026-10-09에 다시 열어 수치를 대조했습니다.
이 글에서 다루는 핵심 3가지
M4 Mac mini 16GB에서는 MAI-Code-1.1-Flash 로컬 버전을 시도할 이유가 없었습니다. 3비트급으로 줄인 가중치만 53GB라서, 운영체제와 KV 캐시를 빼기도 전에 메모리 16GB의 3배를 넘습니다. 이 글은 모델을 받아서 돌려본 기록이 아니라, Microsoft가 공개한 수치로 계산한 사전 점검입니다. 속도와 품질은 재지 않았습니다.
대표 이미지는 Google Flow의 Nano Banana 2.1로 생성한 AI 이미지입니다.
내 메모리로 나눠 본 판단
아래는 공개 수치를 제가 해석한 표입니다.
| 내 기기 메모리 | 판단 | 근거 |
|---|---|---|
| 16GB | 해당 없음 | 가중치 53GB만으로 3.3배 초과 |
| 64GB | 가중치는 들어가지만 실사용은 미확인 | 피크 75.5GB, 권장 120GB 초과에 모두 못 미침. 컨텍스트를 줄였을 때 피크는 미공개 |
| 128GB급 | 후보 | Microsoft 테스트 기기와 같은 급 |
Microsoft가 공개한 수치
| 항목 | 공개된 값 | 출처 |
|---|---|---|
| 구조 | 총 137B, 활성 6.8B, MoE | Command Line 블로그 |
| 로컬 버전 크기 | 53GB, BF16 클라우드 버전 대비 80% 감소 | Command Line 블로그 |
| 양자화 | 발표 글은 3-bit, 기술 글은 혼합 정밀도 약 3.3bit/weight | Microsoft AI, Command Line 블로그 |
| 컨텍스트 | 256K 유지 | Microsoft AI |
| 피크 메모리 | 256K에서 75.5GB (Surface Laptop Ultra, 최대 128GB 통합 메모리 기기) | Command Line 블로그 |
| 권장 사양 | 최상의 성능을 위해 RAM 120GB 초과 | Microsoft AI |
| SWE-Bench Verified | 로컬 양자화 70.80%, 클라우드 72.6% | Command Line 블로그 |
| Terminal-Bench 2.1 | 로컬 양자화 66.29%, 클라우드 62.9% | Command Line 블로그 |
| 테스트 조건 | 2026-10-05, Windows ARM64 llama.cpp CUDA, 합성 코드 생성 워크로드 | Command Line 블로그 |
| Copilot 연동 | 이달 말까지 앱, CLI, VS Code에서 실험적 접근 | Microsoft AI |
53GB와 75.5GB 사이의 22.5GB
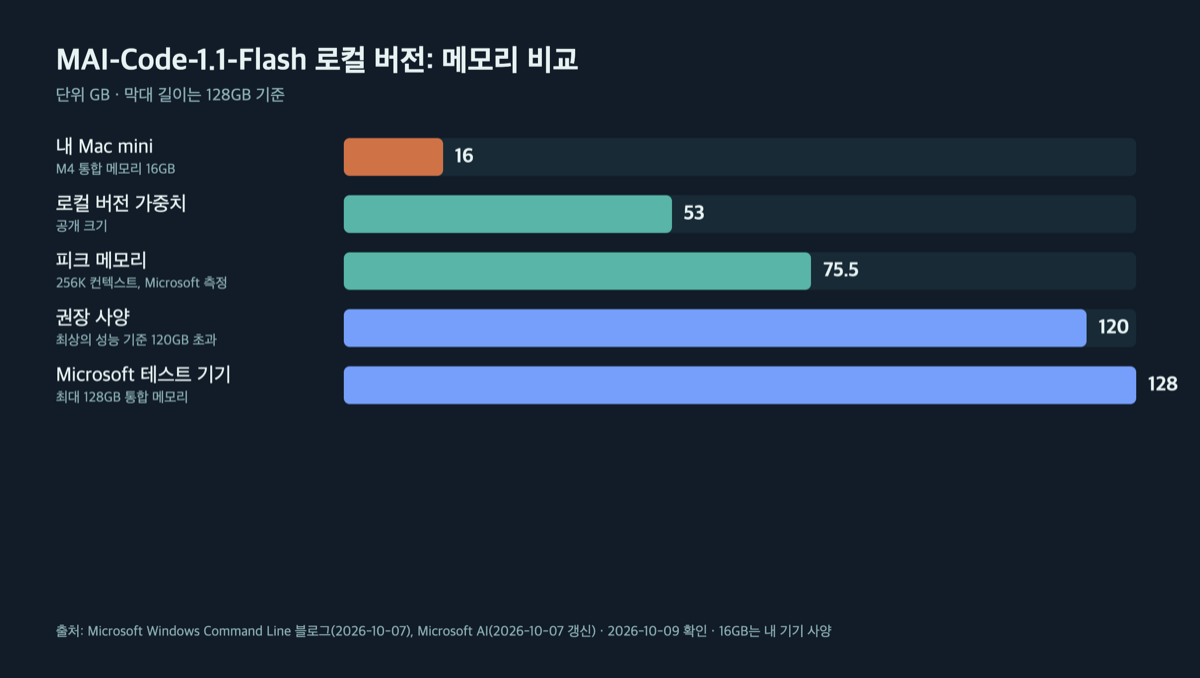
도표는 위 공개 수치로 직접 그렸습니다. 16GB만 제 기기 사양입니다.
공개된 숫자만으로 16GB에서 가능한지 따져봤습니다. 아래 계산은 제가 한 것이고 Microsoft가 내역을 공개한 값이 아닙니다.
가중치 크기  ≈ 137B × 3.3bit ÷ 8 = 약 56.5GB(10진) = 약 52.6GiB
발표된 크기  = 53GB
→ 같은 규모라서 53GB는 파라미터 전체를 담은 크기로 보입니다.

16GB 대비   = 53 ÷ 16 = 약 3.3배
피크 - 가중치 = 75.5 - 53 = 22.5GB
22.5GB 차이에는 KV 캐시, 런타임, 추측 디코딩이 쓰는 작업 메모리가 들어 있습니다. Microsoft 글이 메모리 예산 항목으로 이 요소들을 나열했고 항목별 크기는 공개하지 않았습니다. 컨텍스트를 줄였을 때 피크가 얼마로 내려가는지도 공개된 값이 없습니다. 64K와 128K에서는 프롬프트 처리 속도만 나와 있습니다.
활성 6.8B면 16GB에서도 되지 않을까
MoE라서 토큰마다 쓰는 파라미터는 6.8B뿐이니 메모리도 그만큼이면 되지 않을까 하는 생각이 먼저 들 수 있습니다. 발표된 53GB와 75.5GB는 전체 가중치를 올린 상태의 값으로 보입니다. 활성 파라미터 수는 토큰당 계산량에 가까운 숫자라서 메모리 요구량과는 다른 축입니다.
16GB에서 되려면 전문가 가중치를 SSD에서 읽어오는 전용 런타임이 필요합니다. 제 환경에서는 TurboFieldfare로 Gemma 4 26B-A4B를 돌려본 기록에서 메모리는 2GB로 가벼웠지만 decode 6.26 tok/s였고, 콜드 첫 읽기가 3~4배 느려져서 에이전트용으로는 부적합하다고 판단했습니다. MAI-Code용으로 그런 런타임이 공개됐다는 자료는 찾지 못했습니다. Mac용 런타임과 가중치가 공개되고 실측이 나오면 이 판단은 다시 봐야 합니다.
16GB에서는 다른 모델로
같은 16GB Mac mini에서 제가 직접 돌려본 기준은 Gemma 4 12B를 먼저 돌려본 기록에 있습니다. 12B QAT 후보는 남겼고 반복 작업은 Qwen3 4B급으로 분리했습니다. 코딩 에이전트용으로 어떤 모델이 맞는지는 아직 같은 조건으로 재지 않았습니다.
아직 비어 있는 것
- 가중치 배포 위치와 Apple Silicon 지원 여부
- 컨텍스트별 피크 메모리 (256K 외)
- 실제 토큰 생성 속도와 코딩 작업 완료율의 재현
- Copilot 로컬 모델 기능의 정식 제공 시점과 조건
확인한 자료
- Bringing local models and sandboxed tools to Windows and GitHub Copilot, Microsoft Windows Command Line (2026-10-07)
- MAI-Code-1.1-Flash: Better, faster, at a quarter of the cost, Microsoft AI (2026-10-07 갱신)
- MAI-Code-1.1-Flash available in GitHub Copilot, GitHub changelog (2026-08-11)
이 글에는 제휴 링크가 없습니다. 위 출처는 공개된 수치를 확인하기 위한 자료이고 실행 결과는 포함하지 않습니다.
실행 전에 궁금했던 것
MAI-Code-1.1-Flash는 Mac에서 돌릴 수 있나요?
Microsoft가 공개한 테스트는 Windows ARM64의 llama.cpp CUDA 런타임에서 진행됐습니다. Mac용 런타임이나 가중치가 공개됐다는 자료는 확인하지 못했습니다.
메모리는 얼마나 필요한가요?
로컬 버전 크기는 53GB이고 256K 컨텍스트에서 측정한 피크 메모리는 75.5GB입니다. Microsoft는 최상의 성능을 위해 RAM 120GB 초과를 권장합니다.
로컬 버전이면 오프라인으로 쓰나요?
Microsoft 기술 글은 로컬 추론이 세션을 오프라인으로 만들지는 않는다고 적었습니다. 모델 선택, 추론, 도구 실행의 경계가 각각 다르다는 설명입니다.